De voorgeschiedenis van de browser
Het internet was er eerder dan het web
Internet en het World Wide Web worden vaak als hetzelfde gezien, maar dat zijn ze niet. Het internet is het netwerk waarover computers gegevens uitwisselen. Het web is één van de diensten die daarvan gebruikmaken. Voordat het web doorbrak, verstuurden mensen al e-mail, haalden zij bestanden op met FTP, discussieerden zij in nieuwsgroepen en logden zij met Telnet in op computers op afstand.
Voor iedere dienst was meestal een apart programma nodig. Een mailprogramma kon geen nieuwsgroep openen en een FTP-client was niet bedoeld om een online document te lezen. Er bestond nog geen vanzelfsprekende toegangspoort waarin vrijwel alles samenkwam.
Bestanden zoeken, ophalen en versturen via mappen op een andere computer.
Berichten lezen en beantwoorden in duizenden thematische nieuwsgroepen.
Via tekstcommando's werken op een computer die ergens anders stond.
De droom van verbonden kennis
Het idee om kennis niet alleen in een rechte volgorde te presenteren was ouder dan het internet. In 1945 beschreef Vannevar Bush in zijn essay As We May Think een denkbeeldige machine, de Memex. Gebruikers zouden er persoonlijke routes tussen documenten mee kunnen vastleggen. In de jaren zestig gaf Ted Nelson aan zulke verbindingen de naam hypertext.
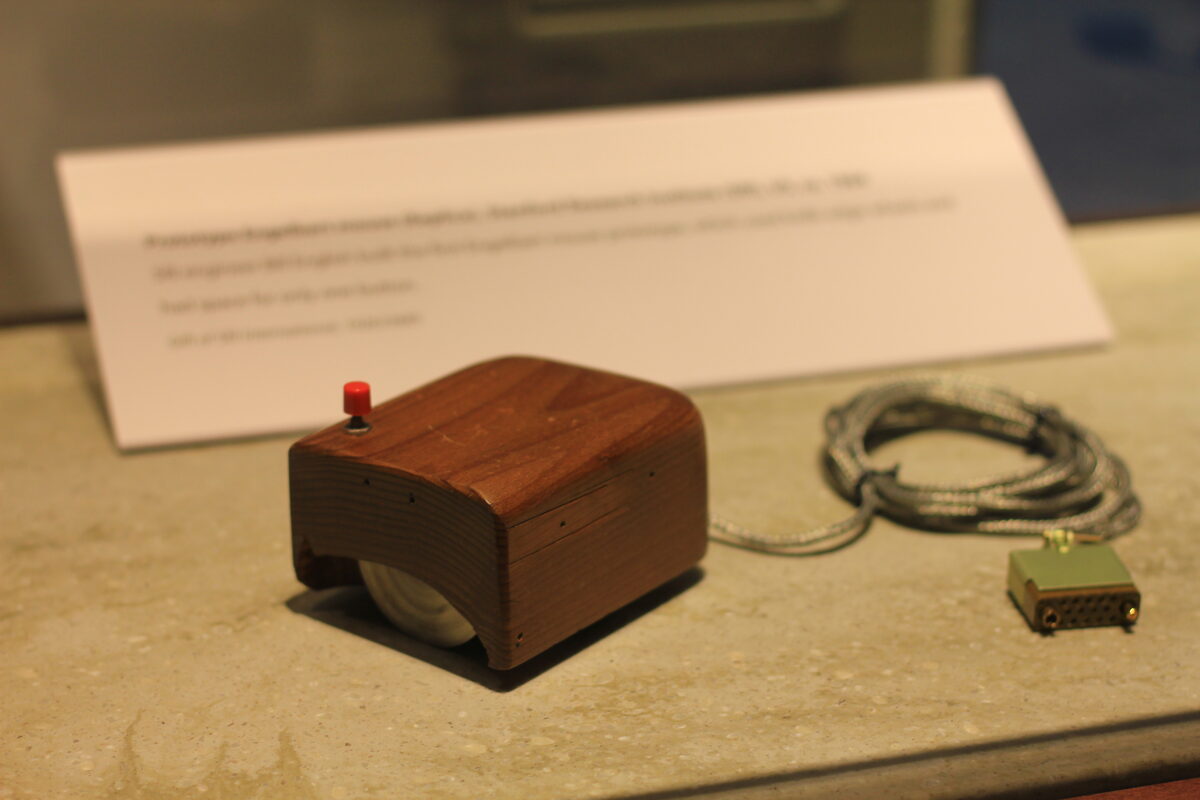
Douglas Engelbart liet in december 1968 zien hoe krachtig zo'n systeem kon zijn. Tijdens de later zo genoemde ‘Mother of All Demos’ demonstreerde zijn team onder meer hyperlinks, samenwerken op afstand, vensters en een muis. Het was nog geen webbrowser, maar het liet wel zien dat een computer meer kon zijn dan een rekenmachine of elektronische typemachine.
Van zoeken naar bladeren
De grote verandering van hypertext zat niet alleen in de techniek, maar ook in het gedrag van de gebruiker. In een traditioneel computersysteem moest je vaak weten welk commando, bestandsadres of menunummer je nodig had. In een hypertextsysteem kon je een gemarkeerde verwijzing volgen en onderweg besluiten waar je verderging.
Daar past het Engelse woord browse goed bij: rondkijken, bladeren, iets verkennen zonder dat de eindbestemming vooraf vaststaat. Een browser werd daarmee niet slechts een programma dat documenten toonde. Het programma maakte een nieuwe manier van lezen mogelijk.
Gopher: het internet als een ordelijke menuboom
Toen het web nog piepjong was, leek Gopher een serieuze kandidaat om de gebruiksvriendelijke voorkant van het internet te worden. De Universiteit van Minnesota bracht de eerste versie in 1991 uit. Gopher presenteerde informatie als een overzichtelijke reeks menu's. Kies een onderwerp, open een onderliggende map en ga verder naar een document, zoekdienst of andere server.
Dat voelde veel eenvoudiger dan het onthouden van commando's en serveradressen. Gopher-clients konden bovendien verwijzingen naar informatie op verschillende computers achter één rustige interface samenbrengen. Volgens de technische beschrijving in RFC 1436 werkte Gopher met een client-servermodel en een eenvoudig protocol voor het zoeken en ophalen van documenten.
Toch bleef de structuur sterk hiërarchisch. Een beheerder bepaalde welke onderdelen in een menu stonden en hoe je van boven naar beneden navigeerde. Het web koos voor een losser model: ieder document kon rechtstreeks naar ieder ander document verwijzen. Dat leverde chaos op, maar ook ongekende vrijheid.
World Wide Web
[1] What is the World Wide Web?
[2] Help using this browser
[3] People involved in the project
[4] Technical details
> 2_
Bij CERN ontstaat een nieuw soort informatiesysteem
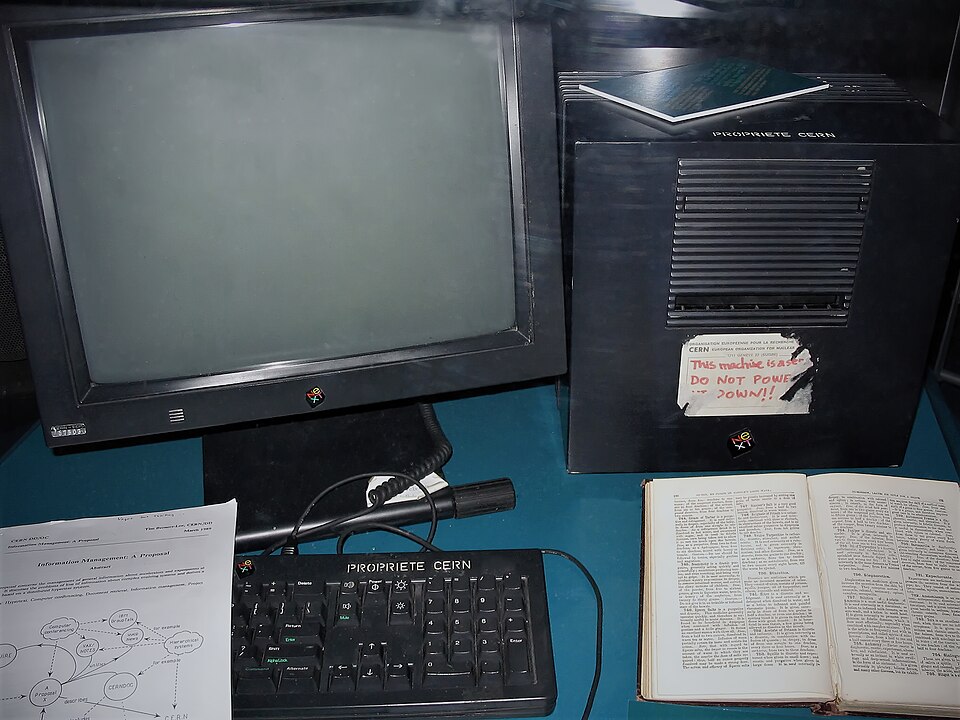
Bij onderzoekscentrum CERN werkten duizenden wetenschappers met uiteenlopende computers en documentatiesystemen. Tim Berners-Lee stelde in maart 1989 een hypertextsysteem voor waarmee informatie over projecten, mensen en apparatuur met elkaar kon worden verbonden. In een uitgewerkte versie uit november 1990 kreeg het project de naam WorldWideWeb.
Het voorstel draaide niet om één grote centrale databank. Documenten mochten op verschillende computers blijven staan. Links zouden de samenhang zichtbaar maken, terwijl een browser de documenten ophaalde en presenteerde. Die combinatie van internet, hypertext, adressen en een open documentformaat werd de basis van het web.
Eén browser was nog niet genoeg
Berners-Lee bouwde eind 1990 op een NeXT-computer het programma WorldWideWeb. Dat was een grafische browser én editor. Het werkte echter alleen op NeXT-systemen, en die stonden lang niet overal. Als het web werkelijk internationaal moest groeien, moest de informatie ook vanaf eenvoudiger computers en tekstterminals bereikbaar zijn.
Daarom ontwikkelde Nicola Pellow bij CERN de Line Mode Browser. Deze browser toonde geen fraaie vensters of afbeeldingen, maar kon op veel verschillende computers draaien. Links kregen nummers; de gebruiker typte het nummer van de gewenste bestemming. Juist die soberheid hielp het web buiten de kleine kring van NeXT-gebruikers te verspreiden.
Nederland in dit hoofdstuk · februari 1992
Nederland haakt aan: Nikhef opent de eerste Nederlandse website
De vroege geschiedenis van de browser speelde zich niet alleen in Genève of de Verenigde Staten af. In Amsterdam volgde Nikhef — het nationaal instituut voor subatomaire fysica — de ontwikkeling van het web op de voet. In februari 1992 werd de website van het instituut operationeel op nic.nikhef.nl, de computer waarop toen ook de netwerkinformatie van Nikhef stond. Het was de eerste Nederlandse website.
De site ging online vóór de komst van Mosaic en jaren voordat een webbrowser op de gemiddelde Nederlandse pc stond. Een bezoeker met de Line Mode Browser zag geen logo's, foto's of gekleurde knoppen, maar een lijst met genummerde links. Door een nummer in te typen kon die bezoeker verder bladeren door informatie over Nikhef, onderzoek en netwerken.
NIKHEF GUIDE
[1] General information
[2] Research groups
[3] Network information
[4] CERN World Wide Web project
Select: 1_
Juist de sobere tekstbrowser maakte deze Nederlandse primeur mogelijk. Een grafische NeXT-computer was niet nodig: een gangbare terminal met internettoegang volstond. Nikhef laat zo zien hoe het web zich eerst via universiteiten, onderzoeksinstituten en academische netwerken verspreidde, nog vóór het bij een groot publiek bekend werd.
De historische pagina van Nikhef bewaart niet alleen een weergave van de oude site, maar ook correspondentie over de webserver met Tim Berners-Lee. Daarmee krijgt het abstracte verhaal van protocollen en browsers een concrete Nederlandse plek: Amsterdam, februari 1992.
Bekijk Nikhefs historische webpagina ↗De browser als universele toegangspoort
De eerste browsers hadden nog geen tabbladen, zoekvak of verzameling uitbreidingen. Veel functies die wij nu als onmisbaar zien, zouden pas later ontstaan. Het beslissende idee was eenvoudiger: één programma kon een document openen en via links nieuwe documenten vinden, ook wanneer die op andere servers stonden.
Daarmee verschoof de verantwoordelijkheid. Een gebruiker hoefde niet langer alle routes en opslagplaatsen te kennen. De browser vertaalde adressen, verbindingen en opmaak naar een leesbare pagina. Het netwerk verdween niet, maar werd voor het eerst enigszins onzichtbaar.
In het volgende hoofdstuk bekijken we WorldWideWeb zelf: de eerste browser, die opvallend genoeg niet alleen bedoeld was om het web te lezen, maar ook om het te schrijven.